海量数据处理的大杀器 腾讯分布式数据仓库(TDW)数据处理服务
引言
在大数据时代,企业内部每天产生的数据量呈指数级增长。如何高效、稳定地存储、计算和分析这些海量数据,成为每个互联网企业和传统行业数字化转型中的核心挑战。腾讯分布式数据仓库(Tencent Distributed Data Warehouse,简称TDW)正是为应对这一挑战而诞生的海量数据处理平台,作为腾讯大数据生态中的核心基础设施,TDW承载了腾讯内部绝大多数离线数据处理任务,并逐渐对外开放,成为企业级数据处理的重要工具。
一、TDW的定位与整体架构
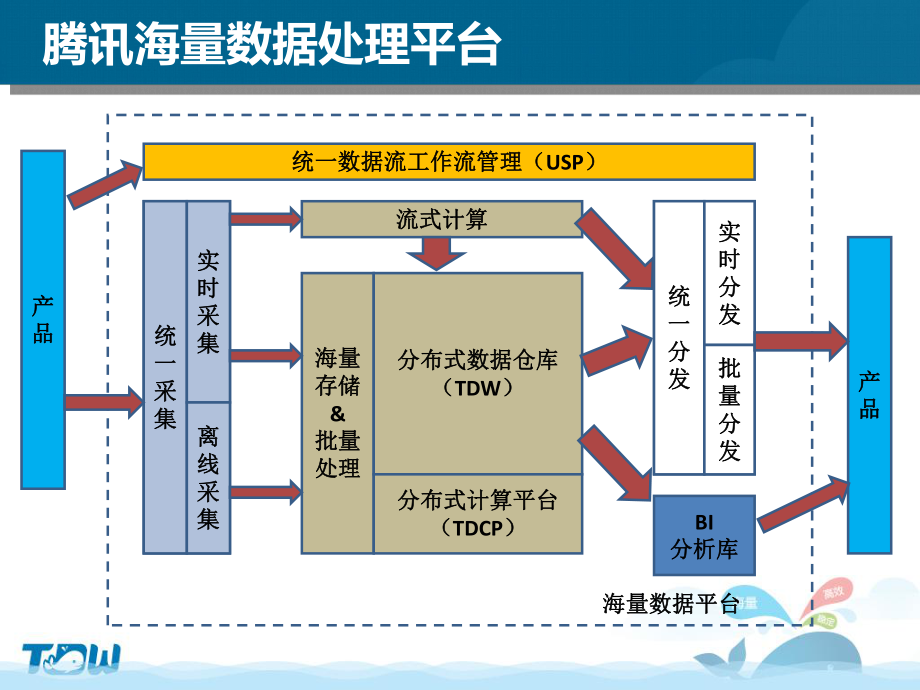
TDW是腾讯自研的分布式数据仓库系统,定位于PB级乃至EB级海量数据的存储与计算服务。它并非单一产品,而是一套融合了分布式存储、分布式计算、资源调度、数据管理和开发工具在内的完整数据处理体系。
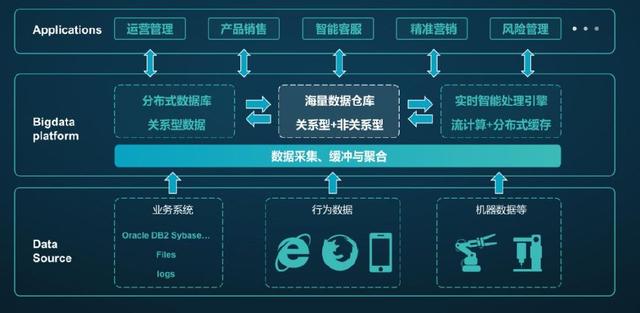
从架构上看,TDW大致可分为以下几个层次:
- 存储层:基于分布式文件系统提供高可靠、高吞吐的数据存储能力,支持结构化、半结构化和非结构化数据的统一管理。
- 计算层:涵盖批量计算、交互式查询、机器学习等多种计算引擎,能够满足不同场景下的数据处理需求。
- 资源调度层:通过统一的资源管理系统实现对计算资源和存储资源的弹性调度与隔离,保障多租户环境下的任务稳定运行。
- 数据管理层:提供元数据管理、数据权限控制、数据血缘追踪、数据质量管理等能力,确保数据资产的可管可控。
- 开发与运维层:提供SQL开发、任务编排、监控告警、运维管理等工具,降低用户的使用门槛。
二、核心能力解析
1. 海量数据存储能力
TDW的存储层采用分布式架构,数据被切分并多副本存储在大量普通服务器上,既保证了数据的可靠性,又实现了存储容量的线性扩展。对于PB级的数据表,TDW能够以较高的吞吐量完成数据的写入与读取,并支持分区表、列式存储、压缩编码等优化手段,在存储成本和查询效率之间取得平衡。
2. 多样化计算引擎
TDW并非绑定单一计算框架,而是根据业务场景提供多种计算引擎。对于大规模批量处理任务,可采用分布式批处理引擎进行全量计算;对于交互式分析场景,则提供低延迟的查询引擎支持即席查询;此外还支持机器学习、图计算等专用计算能力。这种多引擎融合的设计,使TDW能够覆盖从ETL处理、报表统计到数据挖掘的完整数据链路。
3. 统一的资源调度与多租户隔离
在腾讯内部,TDW服务着众多业务团队,每天运行的任务数量以百万计。统一资源调度系统能够根据任务优先级、资源需求和队列策略进行动态分配,实现计算资源的共享与隔离。这不仅提高了集群的整体利用率,也保障了关键业务任务的SLA。
4. 数据管理与治理
海量数据环境下,数据资产的管理和治理尤为重要。TDW提供完善的元数据服务,用户可以清晰地了解每张表的结构、来源、更新频率和使用情况。数据权限体系支持细粒度的访问控制,数据血缘分析帮助追踪数据的加工链路,数据质量监控则能够及时发现异常数据,保障数据可信度。
5. 易用的开发工具链
TDW提供类SQL的开发语言,大幅降低了大数据处理的门槛。用户无需深入了解分布式系统的底层细节,即可通过编写SQL完成复杂的数据加工逻辑。任务编排工具支持依赖关系的可视化配置,监控系统提供任务运行的实时状态和日志查询,形成从开发到运维的闭环体验。
三、典型应用场景
TDW在腾讯内部的应用覆盖了社交、游戏、金融科技、广告营销等多个业务领域。典型的应用场景包括:
- 日志分析与用户行为分析:对海量用户行为日志进行清洗、聚合和建模,支撑产品运营决策。
- 报表与指标体系构建:作为企业级数据仓库的核心引擎,承载各类经营报表和指标计算任务。
- 数据挖掘与机器学习特征工程:为算法模型提供大规模特征加工和样本生成能力。
- 数据集成与ETL:完成不同数据源之间的数据抽取、转换和加载,构建统一的数据底座。
四、面向未来的演进方向
随着数据规模的持续增长和业务需求的不断变化,TDW也在持续演进。一方面,云原生架构的引入使TDW具备更强的弹性和更低的运维成本;另一方面,湖仓一体、实时离线一体化等理念的落地,正在推动TDW从传统数据仓库向更开放、更统一的数据平台方向发展。在数据安全与合规要求日益严格的背景下,TDW也在不断加强数据加密、访问审计和隐私保护能力。
##
腾讯分布式数据仓库TDW作为海量数据处理的重要基础设施,凭借其分布式存储、多样化计算、统一调度和完善的数据治理能力,已成为支撑腾讯大数据体系的关键支柱。对于面临海量数据挑战的企业而言,TDW所代表的技术思路——以统一平台承载多样化的数据负载、以治理能力保障数据资产价值——具有很强的参考意义。在大数据技术持续演进的今天,TDW仍将不断迭代,为更广泛的数据处理场景提供坚实支撑。
如若转载,请注明出处:http://www.henandingcan.com/product/45.html
更新时间:2026-10-30 16:58:12